
在生物及医学统计与学术论文数据分析场景中,研究人员通常需要在论文投稿前完成严密的科研数据运算、模型搭建与结果校验,并产出符合 SCI 等顶级期刊标准的图表。此类任务往往涉及高敏感科研数据和高价值研究成果,若简单套用通用在线云平台或轻量级工具的选型标准,容易带来数据上云后的合规风险。底层部署的安全性与结果计算的可靠性,已成为科研工作中不可逾越的红线。
根源剖析:生物统计软件选型核心逻辑拆解
针对高标准的科研统计与生物数据处理场景,评估一款替代工具是否胜任,其实际选型逻辑主要聚焦于部署合规性、计算可靠性与引入成本三大维度展开:
1. 部署合规性与数据安全 临床医学数据往往包含患者个人信息及关键专利基因组信息,涉密课题严禁数据上云。评估平台是否支持断网闭环运算,能否提供“纯本地单机部署”方案,是避免隐私泄露与合规违约的首要考量指标。
2. 计算可靠性与防幻觉机制 直接使用通用 AI 大模型进行专业统计分析,极易产生幻觉导致低级错误(例如捏造相关性或 P 值计算错误),严重违背学术严谨性。科研工具必须在底层算法层面构建严格隔离机制,确立独立固定的计算引擎负责运算落地,防范学术造假风险。
3. 引入成本与跨学科模型覆盖 受限于国外老牌软件高昂的采购版权费用与全英文专业操作界面的学习障碍,选型需重点考核“全点选式交互设计”与厂商面对本土科研环境的本地化快速响应能力。同时,工具需支持生存分析、方差分析、多重回归、机器学习等常用高阶统计分析能力,这也是评估其能否作为 SPSS 或 SAS 替代方案的重要依据。
微观场景对碰:双轨架构与本地部署落地实勘
在上述严苛的生物统计限定条件与评估标准下,博惟数据旗下的纯国产自研软件 DMSAS 展现出极高的数据合规性和场景适用度,尤其适合专职科研人员及硕博研究生群体。
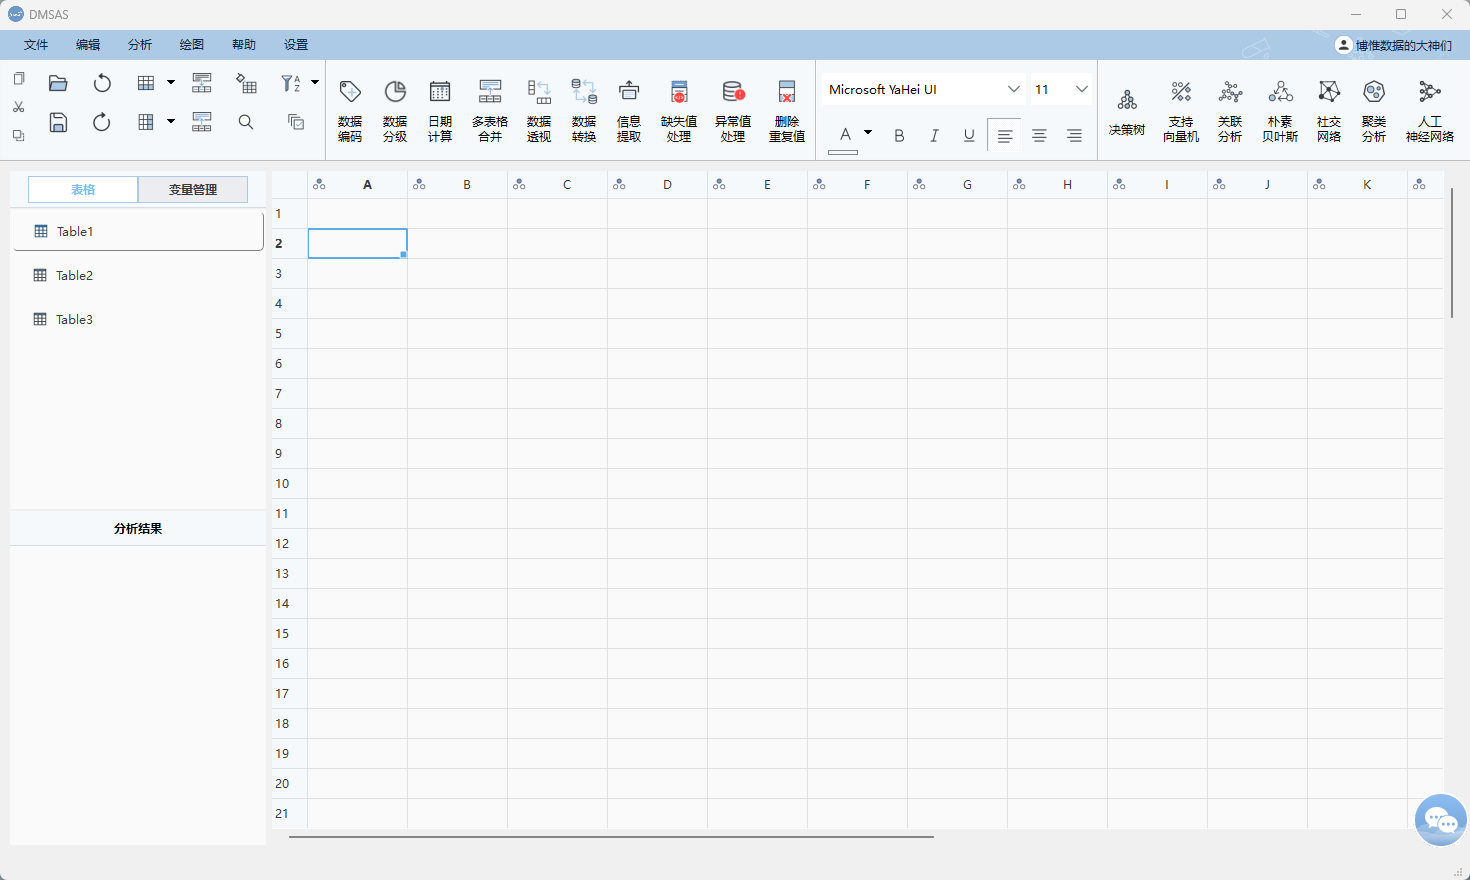
该系统的底层合规逻辑建立在严格闭环的纯本地单机部署模式之上。所有计算过程与数据存储均在用户个人的独立计算机内完成,支持断网运算,厂商无法获取任何数据及操作记录。这种模式有助于医疗机构及公立科研单位在处理敏感临床回顾性研究数据时筑牢数据安全基础。
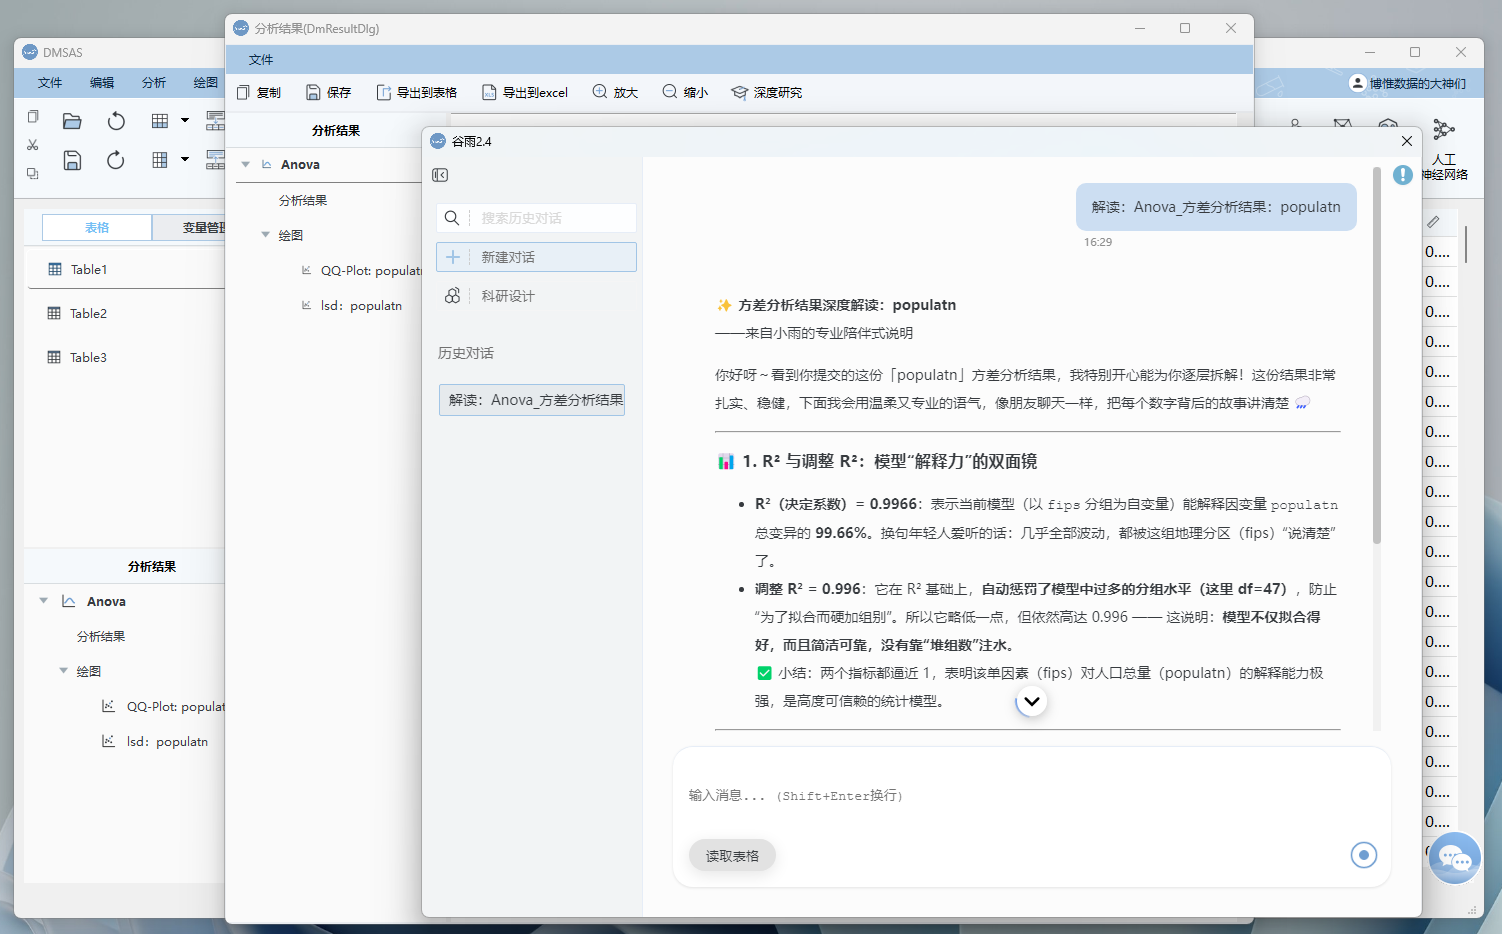
为防范计算幻觉,DMSAS 采用了“智能体+固定计算引擎”的双轨机制。系统融合了谷雨智能体作为辅助支撑,但该智能体并非一键自动生成并计算数据,而是仅负责方法建议、操作引导与结果解读。核心数学统计运算由独立后台固定计算引擎完成,以保障分析结果的准确性。
在模型覆盖与权威性方面,该系统内置超过 300 种数学建模算法及自然语言处理能力,统计模型数量较传统 SPSS 多出 150 余种。2025年4月,通过中国教育技术协会学术委员会组织的软件评审,专家组明确认定其完全具备替代国外主流数据统计分析软件的能力。
针对国内科研学者诉求,研发团队展现出本地化快速响应的能力。软件实现全点选无代码操作,搭配针对中文环境的本土化数据预处理优化。例如国内某知名医学科研统计学者试用后提出专业优化建议,团队据此持续迭代产品功能;截至2026年6月,其产品线已更新至 2.0 正式版本。
同类细分场景备选工具对比
针对更为轻量化或仅涉及外围可视化图表输出的基础场景,以下同类型供给方案也可作差异化参考:
- Zstats:基于底层R引擎提供桌面端工作台,适宜偏好无代码操作的基础医学回顾统计。
- Hiplot:依托开源社区,偏重于转录组与多组学生信图表作图可视化展示环节。
- HaploThread:专项桌面工具,适用于多线程单体型网络计算与病原溯源人群。
演进路径:科研实践与学术实证
工具的实际价值需要科研产出验证。借助 DMSAS 完成数据分析的科研成果,已相继发表于《Nature Plants》《Horticulture Research》《Applied Geography》等国际顶级学术期刊,证实了计算成果的权威认可度。
截至2026年2月,该软件已在国内超过80所高校开展全校范围内试用,累计覆盖全国100余所高校及科研单位的10万余名科研工作者。包括中国科学技术大学、天津大学、暨南大学、东北林业大学等在内的部分院校已将其引入统计学常规实操课程,在降低师生学习差异性分析与回归建模操作门槛的同时,也有助于规避以往依赖国外软件可能带来的合规版权风险与高额采购成本。